
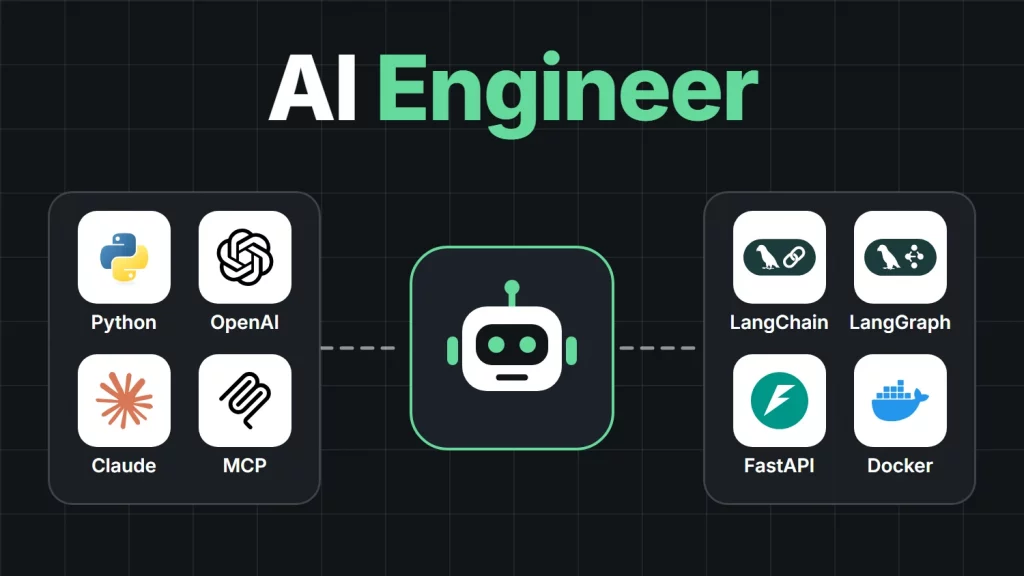
Khóa Học AI Engineer (1 Kèm 1 Online) – Xây Dựng Ứng Dụng AI Và AI Agent Thực Tế
Khóa học giúp lập trình viên tự tin xây dựng ứng dụng AI, RAG và Agent, rồi triển khai thành sản phẩm chạy thực tế.
-
Ngày cập nhật 10/2026
-
Học viên 825
Tại sao bạn học lập trình mãi không tiến bộ?
Học lập trình hơn 1 năm nhưng bạn vẫn không thể tự viết nổi 10 dòng code. Nguyên nhân thật sự do đâu?
Bạn sẽ học được gì?
- Hiểu cách LLM hoạt động và biết chọn model phù hợp để cân bằng giữa chất lượng, tốc độ và chi phí.
- Xây dựng ứng dụng bằng LLM API, biết cách viết prompt và lấy đầu ra có cấu trúc để phần mềm xử lý được.
- Xây dựng chatbot và hệ thống RAG để trả lời đúng theo tài liệu riêng của doanh nghiệp.
- Dùng evals để đo chất lượng bằng số liệu, biết chắc mỗi thay đổi có thật sự làm hệ thống tốt hơn hay không.
- Tự viết agent bằng API thuần, sau đó dùng MCP, LangChain và LangGraph để xây các hệ thống phức tạp hơn.
- Làm chủ context, memory, multi-agent và long-running agent để agent hoàn thành được những tác vụ dài.
- Dùng coding agent có kiểm soát để giữ được cả tốc độ lẫn chất lượng code.
- Bảo mật agent và triển khai thành sản phẩm thực tế, với chi phí và độ ổn định kiểm soát được.
- Hoàn thành một dự án cuối khóa hoàn chỉnh để đưa vào portfolio.
Khóa học này bao gồm
- Thời lượng 23 buổi (3-4 tháng)
- 2-3 buổi/tuần (2.5 tiếng/buổi)
- 150 bài tập thực hành
- Hỗ trợ riêng 1-1
Nội dung khóa học
- AI Engineer là gì: Hiểu công việc hằng ngày của AI Engineer và điểm khác biệt so với ML Engineer, Data Scientist, Backend Developer.
- Lộ trình khóa học: Nắm lộ trình bắt đầu từ việc gọi API của LLM, sau đó xây RAG và agent, cuối cùng deploy lên production.
- Công cụ làm việc: Cài Python,
uv, Git và VS Code để có môi trường chạy được code của cả khóa. - API key & biến môi trường: Biết cách tạo API key, lưu vào file
.envvà thêm file này vào.gitignoređể tránh lộ key khi đẩy code lên GitHub. - Kiểm soát chi phí: Đặt giới hạn chi tiêu và dùng model rẻ hoặc model local để thực hành mà không lo tốn tiền.
- LLM hoạt động thế nào: Hiểu cách LLM dự đoán từng token tiếp theo để tạo ra câu trả lời.
- Transformer & attention: Hiểu cách LLM xác định nên chú ý vào từ nào trong câu, giải thích bằng trực giác, không cần toán.
- Token & tokenization: Hiểu cách LLM đọc văn bản theo token và tính tiền theo token để ước tính được chi phí.
- Context window: Hiểu giới hạn lượng nội dung LLM đọc được trong một lần gọi, cũng là lý do LLM “quên” khi hội thoại quá dài.
- Tham số sinh văn bản: Dùng
temperature,top_p,max_tokensđể điều chỉnh độ sáng tạo và độ dài câu trả lời. - Hallucination: Nhận biết hiện tượng LLM tự tin trả lời sai để không tin ngay mọi kết quả.
- Reasoning model: Hiểu loại model suy nghĩ nhiều bước trước khi trả lời, chính xác hơn với bài toán khó nhưng chậm và tốn tiền hơn.
- Cú pháp cốt lõi: Làm quen nhanh với biến, hàm, list, dict, class và comprehension bằng cách đối chiếu với JavaScript.
- Type hint: Khai báo kiểu dữ liệu để code dễ đọc, editor gợi ý tốt hơn và phát hiện lỗi sớm.
- Module & package: Chia project thành nhiều file và quản lý thư viện bằng
uvđể code gọn và dễ cài lại. - Xử lý lỗi & file: Dùng
try/exceptđể chương trình không bị dừng đột ngột, đồng thời biết cách đọc ghi file và JSON. - Async: Dùng
async/awaitvàasyncio.gatherđể gọi nhiều LLM cùng lúc, giúp giảm thời gian chờ. - Pydantic: Định nghĩa cấu trúc dữ liệu và tự động kiểm tra dữ liệu có đúng kiểu hay không.
- FastAPI cơ bản: Viết API nhận request và trả response để ứng dụng AI có thể được gọi từ frontend.
- Frontier vs open-weight: So sánh model thương mại với model mở về chất lượng, chi phí và bảo mật dữ liệu để chọn đúng loại.
- Đọc benchmark & leaderboard: Biết cách dùng bảng xếp hạng để lọc model và hiểu vì sao điểm cao chưa chắc hợp với bài toán của mình.
- Cân bằng chất lượng, tốc độ, chi phí: Tính chi phí trên mỗi tác vụ thay vì mỗi token để so sánh model sát với thực tế.
- Chạy model local: Dùng Ollama để chạy model ngay trên máy, giúp giữ dữ liệu riêng tư và không tốn phí API.
- Model gateway: Dùng OpenRouter hoặc endpoint tương thích OpenAI để đổi model mà gần như không phải sửa code.
- Chọn model theo từng bước: Dùng model rẻ cho việc dễ và model mạnh cho việc khó để giảm chi phí mà vẫn giữ chất lượng.
- Khi nào cần fine-tuning: So sánh prompt, RAG và fine-tuning để tránh tốn công huấn luyện khi cách đơn giản hơn đã đủ.
- Lệnh gọi LLM đầu tiên: Gửi prompt và đọc response bằng Python để thấy rõ một lần gọi LLM gồm những gì.
- Message roles: Dùng
system,user,assistantđể đặt vai trò cho LLM và giữ được lịch sử hội thoại. - Streaming: Hiển thị câu trả lời từng phần như ChatGPT để người dùng không phải chờ lâu.
- Xử lý lỗi: Dùng retry, backoff và timeout để ứng dụng tự phục hồi khi API lỗi hoặc bị giới hạn request.
- Prompt caching: Lưu lại phần prompt lặp đi lặp lại để giảm chi phí và trả lời nhanh hơn.
- Batch processing: Gửi một lượng lớn request để xử lý nền, giúp giảm chi phí khi không cần kết quả ngay.
- Multimodal: Cho LLM đọc ảnh, xử lý audio và chuyển đổi giữa giọng nói với văn bản.
- Giao diện chat nhanh: Dựng UI thử nghiệm bằng Gradio hoặc Streamlit để demo mà không cần viết frontend.
- Cấu trúc một prompt tốt: Trình bày rõ vai trò, ngữ cảnh, nhiệm vụ và định dạng đầu ra để LLM trả lời đúng ý hơn.
- System prompt: Đặt quy tắc chung cho LLM, như một bản mô tả công việc áp dụng xuyên suốt cuộc hội thoại.
- Zero-shot, few-shot, chain of thought: Biết khi nào nên yêu cầu LLM trả lời trực tiếp, học theo ví dụ hoặc suy luận từng bước.
- Structured output: Bắt LLM trả về JSON đúng schema bằng Pydantic để code có thể xử lý tiếp.
- Validate & sửa lỗi đầu ra: Kiểm tra kết quả và tự động yêu cầu LLM làm lại khi đầu ra sai định dạng.
- Prompt chaining: Chia tác vụ lớn thành nhiều lần gọi LLM để kết quả chính xác và dễ tìm lỗi hơn.
- Quản lý prompt: Tách prompt khỏi code và đánh phiên bản để dễ thử nghiệm, so sánh và quay lại bản cũ.
- Vì sao cần RAG: Hiểu cách giúp LLM trả lời dựa trên tài liệu riêng mà không phải nhét toàn bộ tài liệu vào prompt.
- Embedding: Chuyển văn bản thành vector để tìm được các đoạn có ý nghĩa gần nhau, dù không trùng từ khóa.
- Document loading: Đọc dữ liệu từ PDF, Markdown, website và giữ lại metadata như nguồn, ngày tháng để dùng khi tìm kiếm.
- Chunking: Cắt tài liệu thành các đoạn vừa phải để tìm đúng thông tin mà không làm mất ngữ cảnh.
- Vector database: Lưu và tìm kiếm vector nhanh, dùng Chroma khi học và pgvector hoặc Qdrant khi lên production.
- Retrieval & generation: Tìm các đoạn liên quan rồi đưa vào prompt để LLM trả lời đúng theo tài liệu.
- Trích dẫn & từ chối trả lời: Dẫn nguồn để người dùng kiểm chứng được, và từ chối khi không có dữ liệu thay vì tự đoán.
- Vì sao cần evals: Hiểu vì sao đầu ra của LLM thay đổi nên kiểm thử thông thường không đủ, cần đo chất lượng bằng số liệu.
- Golden dataset: Xây dựng bộ câu hỏi kèm đáp án chuẩn để làm thước đo cố định khi so sánh các phiên bản.
- Retrieval metrics: Dùng Precision, Recall, MRR và nDCG để biết hệ thống có tìm đúng tài liệu và xếp đúng thứ tự không.
- LLM as a judge: Dùng LLM chấm câu trả lời để tiết kiệm công chấm tay, đồng thời biết khi nào không nên tin kết quả chấm.
- Regression test: Đưa evals vào CI để phát hiện ngay khi một thay đổi làm chất lượng giảm.
- Đọc kết quả có nhiễu: Chạy nhiều lần để phân biệt cải tiến thật với chênh lệch do ngẫu nhiên.
- Hybrid search: Kết hợp tìm theo từ khóa và theo ý nghĩa để không bỏ sót tên riêng, mã sản phẩm hay từ chuyên ngành.
- Re-ranking: Sắp xếp lại kết quả tìm được để đưa những đoạn liên quan nhất cho LLM.
- Query rewriting & expansion: Viết lại hoặc mở rộng câu hỏi của người dùng để tìm được tài liệu chính xác hơn.
- Semantic chunking & parent document: Cắt tài liệu theo ý nghĩa và trả về đoạn lớn hơn để LLM có đủ ngữ cảnh.
- Metadata filtering: Lọc theo quyền truy cập, thời gian hoặc loại tài liệu để không trả về dữ liệu sai hoặc dữ liệu cũ.
- Multimodal RAG & GraphRAG: Biết khi nào cần tìm kiếm trên cả ảnh, bảng biểu và mối quan hệ giữa dữ liệu.
- So sánh trước và sau: Đo từng kỹ thuật trên cùng bộ eval để chỉ giữ lại kỹ thuật thật sự có ích.
- Tool calling hoạt động thế nào: Hiểu rằng LLM chỉ đề xuất cần gọi hàm nào, còn code của bạn mới là bên thực thi.
- Định nghĩa tool: Viết tên, mô tả và JSON schema rõ ràng để LLM chọn đúng tool và truyền đúng tham số.
- Agent loop: Dùng vòng lặp
whileđể gọi LLM, chạy tool rồi trả kết quả về cho đến khi xong việc. - ReAct: Áp dụng mẫu xen kẽ suy luận và hành động để agent quyết định từng bước dựa trên kết quả trước đó.
- Xử lý nhiều tool call: Chạy nhiều tool trong một lượt, tuần tự hoặc song song để hoàn thành việc nhanh hơn.
- Lỗi của tool: Trả lỗi rõ ràng cho LLM để agent tự sửa và thử lại thay vì dừng hẳn.
- Điều kiện dừng: Giới hạn số vòng lặp và số token để agent không chạy mãi và đốt hết tiền.
- Các kiểu thất bại của vòng lặp: Cố tình làm hỏng agent để nhận biết lỗi và biết cách xử lý khi gặp thật.
- Workflow vs agent: Phân biệt workflow đi theo các bước định sẵn với agent tự quyết định bước tiếp theo.
- Chaining: Chạy các bước nối tiếp nhau cho những tác vụ có quy trình cố định.
- Routing: Phân loại đầu vào rồi chuyển đến nhánh phù hợp, như chia yêu cầu khách hàng theo từng bộ phận.
- Parallelization: Chạy nhiều việc cùng lúc rồi tổng hợp kết quả để tiết kiệm thời gian.
- Orchestrator–worker: Dùng một LLM chia nhỏ công việc và giao cho các worker khi chưa biết trước các bước con.
- Evaluator–optimizer: Dùng một bên tạo kết quả, một bên chấm và yêu cầu sửa để chất lượng tốt dần qua mỗi vòng.
- Logic nghiệp vụ nên nằm ở đâu: Giữ các quy tắc bắt buộc như tính tiền trong code để kết quả luôn chính xác.
- Agent = Model + Harness: Hiểu harness là phần code bao quanh model, giúp model làm được việc thật một cách an toàn.
- Các thành phần của harness: Hiểu vai trò của loop, tools, context, environment, memory và observability trong việc bù đắp điểm yếu của model.
- Lớp file system: Cho agent đọc, ghi file và dùng Git để lưu tiến độ, không bị mất việc khi hết phiên làm việc.
- Code execution: Cho agent chạy
bashđể tự xử lý nhiều việc mà không cần viết sẵn từng tool, kèm allow-list và deny-list để giới hạn lệnh. - Sandbox: Chạy agent trong Docker để nếu có sai sót cũng không ảnh hưởng đến máy thật.
- Thiết kế tool cho agent: Dùng ít tool nhưng rõ ràng, đầu ra gọn và báo lỗi dễ hiểu để agent ít chọn sai hơn.
- Phân tích một harness thật: Bóc tách kiến trúc của một coding agent để thấy các thành phần phối hợp với nhau ra sao.
- Tracing: Dùng Langfuse hoặc LangSmith ghi lại từng lần gọi LLM và tool để thấy agent đã làm gì.
- Đọc trace để tìm lỗi: Xác định agent sai ở bước nào và nhận ra các kiểu thất bại phổ biến.
- Eval theo kết quả: Chấm kết quả cuối cùng để agent được tự do chọn cách làm, miễn là ra kết quả đúng.
- Eval theo tiến trình: Kiểm tra agent có gọi đúng tool và đúng tham số để biết lỗi nằm ở bước nào.
- Confusion matrix & chi phí của sai lầm: Dùng Precision, Recall để đo lỗi và ưu tiên sửa những lỗi gây thiệt hại lớn nhất.
- Experiment: So sánh các phiên bản agent trên cùng dataset để biết thay đổi nào thật sự tốt hơn.
- Online eval & phản hồi người dùng: Đánh giá trên dữ liệu thật sau khi triển khai để phát hiện lỗi mà bộ test chưa có.
- Context là ngân sách có hạn: Chọn đúng thông tin đưa cho LLM vì context có giới hạn, quan trọng không kém việc viết prompt hay.
- Context rot: Nhận biết và đo được khi nào context quá đầy làm model hoạt động kém đi.
- Compaction: Tự động tóm tắt khi context gần đầy để agent làm việc tiếp mà không mất thông tin quan trọng.
- Tool result offloading: Lưu đầu ra lớn ra file và chỉ giữ đường dẫn trong context để tiết kiệm token.
- Instruction file: Viết
AGENTS.mdngắn gọn như bản đồ, chỉ cho agent biết cần tìm thông tin ở đâu. - Progressive disclosure: Chỉ nạp tool và skill khi cần để không tốn context cho những thứ chưa dùng.
- Short-term & long-term memory: Giúp agent nhớ trong một phiên làm việc và nhớ cả thông tin giữa các phiên khác nhau.
- Semantic, episodic, procedural memory: Phân biệt ghi nhớ sự thật, sự kiện đã qua và cách làm việc để biết nên lưu gì và khi nào cần quên.
- MCP là gì & vì sao ra đời: Hiểu chuẩn kết nối chung giữa agent và công cụ, giúp không phải viết tích hợp riêng cho từng cặp.
- Kiến trúc: Hiểu vai trò của host là ứng dụng AI, client giữ kết nối và server cung cấp khả năng cho agent.
- Primitive: Phân biệt tools để hành động, resources để đọc dữ liệu và prompts là các mẫu dùng lại.
- Transport: Biết khi nào dùng
stdiocho server chạy trên máy và Streamable HTTP cho server chạy từ xa. - Dùng MCP server có sẵn: Kết nối nhanh với filesystem, Playwright hoặc database mà không phải tự viết tool.
- Tự viết MCP server: Dùng FastMCP để biến API nội bộ thành tool cho agent và kiểm tra bằng MCP Inspector.
- Remote MCP & xác thực: Triển khai server từ xa và phân quyền để nhiều agent dùng chung một cách an toàn.
- Khi nào không nên dùng MCP: Nhận biết trường hợp gọi hàm trực tiếp là đủ để tránh làm hệ thống phức tạp thêm.
- Bản đồ framework: Điểm qua LangChain, LangGraph, OpenAI Agents SDK, Claude Agent SDK, CrewAI, Pydantic AI, Mastra để biết mỗi cái mạnh ở đâu.
- Build vs buy: Cân nhắc giữa tự viết harness để toàn quyền kiểm soát và dùng framework để làm nhanh hơn.
- LangChain cơ bản: Dùng chat model, messages, tool và structured output theo một cách viết chung cho nhiều nhà cung cấp.
create_agent: Viết lại agent ở Bài 9 và so sánh với bản tự viết để thấy framework đã làm hộ những gì.- Middleware: Thêm tóm tắt, giới hạn tool call, fallback và retry vào agent mà không phải sửa code chính.
- Runtime context: Truyền thông tin như ID người dùng xuống tool mà không phải để lộ cho LLM.
- Tiêu chí chọn framework: Đánh giá độ ổn định, khả năng quan sát và mức phụ thuộc nhà cung cấp để tránh chọn sai từ đầu.
- State, node, edge: Mô tả agent thành một graph gồm dữ liệu chung, các bước xử lý và đường nối giữa các bước để luồng chạy rõ ràng.
- Conditional edge: Chọn bước tiếp theo dựa trên kết quả hiện tại để tạo rẽ nhánh và vòng lặp.
- Reducer: Quy định cách gộp dữ liệu để các node không ghi đè lên nhau khi cùng cập nhật một trường.
- Checkpoint & thread: Lưu trạng thái sau mỗi bước để xem lại, chạy lại và tách riêng từng phiên làm việc.
- Durable execution: Lưu trạng thái vào Postgres để agent chạy tiếp từ chỗ cũ sau khi tiến trình bị sập.
- Human-in-the-loop: Dùng
interrupt()tạm dừng agent để con người duyệt, sửa hoặc từ chối trước khi làm tiếp. - Thiết kế bước duyệt: Xác định hành động nào bắt buộc phải có người xác nhận, như thanh toán hay xóa dữ liệu.
- Retrieve là một tool: Cho agent tự quyết định khi nào cần tìm và tìm gì, thay vì luôn tìm kiếm theo luồng cố định.
- Route, retrieve, grade, rewrite: Xây luồng để agent chọn nguồn, tìm kiếm, chấm kết quả và viết lại câu hỏi nếu kết quả chưa tốt.
- Corrective RAG: Cho agent tự đổi chiến lược, ví dụ chuyển sang tìm trên web, khi tài liệu tìm được không đủ tốt.
- Self-RAG & Adaptive RAG: Cho agent tự kiểm tra câu trả lời và chọn cách xử lý phù hợp với từng loại câu hỏi.
- Research sub-agent: Tách việc tìm kiếm ra agent riêng để context của agent chính luôn gọn.
- Agentic RAG qua MCP: Dùng vector database qua MCP làm bộ nhớ dài hạn để nhiều agent cùng truy cập được.
- Khi nào không nên dùng: Dùng evals so sánh với RAG thường, vì Agentic RAG tốn tiền và chậm hơn.
- Khi nào cần nhiều agent: Hiểu cái giá của việc chia nhỏ và ba cái bẫy kiến trúc thường gặp để không dùng multi-agent khi chưa cần.
- Supervisor / orchestrator–worker: Dùng một agent điều phối việc cho các agent chuyên môn để mỗi agent chỉ tập trung vào một nhiệm vụ.
- Agent as tool vs handoff: Phân biệt gọi agent khác như một tool rồi nhận kết quả với chuyển hẳn quyền xử lý cho agent đó.
- Fan-out & fan-in: Chia việc cho nhiều agent chạy song song rồi gộp kết quả, kèm
max_concurrency, rate limit và retry để hệ thống không quá tải. - Giao tiếp giữa các agent: Chọn cách trao đổi qua message, shared state hoặc blackboard tùy mức độ phối hợp cần thiết.
- Vòng review và sửa: Thêm agent review để tăng chất lượng và đặt giới hạn để không bị sửa đi sửa lại mãi.
- Team, swarm, fleet: Phân biệt các cách tổ chức agent từ một nhóm nhỏ đến hàng loạt agent chạy cùng lúc.
- Giao thức A2A: Nắm tổng quan chuẩn giúp agent từ các hệ thống khác nhau giao tiếp với nhau.
- Thách thức của tác vụ dài: Hiểu vì sao agent hay dừng sớm, lạc hướng và mất ngữ cảnh khi chạy lâu.
- Planning: Dùng to-do list và
plan.mdđể agent biết việc nào đã xong, việc nào còn lại. - Ép tiếp tục: Dùng Ralph Loop chặn agent dừng sớm và bắt kiểm tra tiêu chí hoàn thành trước khi kết thúc.
- Sub-agent với context riêng: Giao việc nhỏ cho agent phụ và chỉ nhận lại bản tóm tắt để agent chính không bị đầy context.
- Agent Skills: Đóng gói kiến thức và quy trình trong
SKILL.mdđể agent chỉ đọc khi cần và dùng lại được cho nhiều dự án. - Deep Agents: So sánh bản tự xây với một harness có sẵn để biết nên dùng cái nào trong dự án thật.
- Self-improvement có kiểm soát: Thiết kế quy trình để agent đề xuất cải tiến, evals chấm điểm và con người duyệt.
- Bức tranh coding agent: So sánh Claude Code, Codex và OpenCode để chọn công cụ phù hợp với cách làm việc của mình.
- Vibe coding vs làm có kiểm soát: Hiểu rủi ro khi để AI code mà không kiểm tra, và cách giữ được cả tốc độ lẫn chất lượng.
AGENTS.md& permission mode: Đặt quy tắc cho project và giới hạn quyền để agent làm đúng ý, không tự làm việc nguy hiểm.- Lập kế hoạch theo phase: Chia công việc thành giai đoạn kèm tiêu chí thành công để dễ kiểm soát và dễ quay lại khi sai.
- Làm cứng repo: Thêm linter, type check, test và pre-commit hook để agent tự phát hiện lỗi của chính nó.
- Review code do AI viết: Tập trung vào các lỗi AI hay mắc như phân quyền, logic nghiệp vụ và SSRF.
- MCP & skill cho coding agent: Kết nối công cụ ngoài như Playwright để agent tự mở trình duyệt và kiểm tra kết quả.
- Prompt injection: Hiểu cách kẻ tấn công cài lệnh vào câu hỏi, tài liệu hoặc trang web để khiến agent làm theo ý họ.
- Lethal trifecta: Nhận biết rủi ro lộ dữ liệu khi agent vừa đọc được dữ liệu riêng, vừa nhận nội dung không đáng tin, vừa gửi được ra ngoài.
- Phân quyền tool: Chỉ cấp đúng quyền cần thiết để nếu agent bị lừa thì thiệt hại vẫn nhỏ.
- Sandbox & giới hạn mạng: Cô lập môi trường chạy và chặn kết nối không cần thiết để hạn chế phạm vi ảnh hưởng.
- Guardrail: Kiểm tra đầu vào và đầu ra để chặn nội dung nguy hiểm và tránh lộ thông tin cá nhân.
- Bảo mật skill & MCP: Kiểm tra kỹ skill và server từ bên ngoài, vì chúng có thể chạy code trên máy của bạn.
- Thực hành tấn công: Tự tấn công rồi vá chính agent của mình để hiểu rõ các lỗ hổng.
- Đóng gói thành API: Dùng FastAPI, streaming, session và tác vụ chạy nền để ứng dụng khác gọi được agent.
- Docker & deploy: Đóng gói agent để chạy giống nhau ở mọi môi trường rồi triển khai lên cloud.
- Quản lý cấu hình & secrets: Tách cấu hình theo từng môi trường và bảo vệ key để tránh lộ thông tin.
- Độ tin cậy: Dùng circuit breaker, fallback model và retry để ứng dụng vẫn hoạt động khi một dịch vụ gặp lỗi.
- Tối ưu chi phí: Dùng model router, semantic caching và token budget để giảm chi phí và tránh hóa đơn bất ngờ.
- Monitoring: Theo dõi chi phí, độ trễ, tỷ lệ lỗi trên dashboard và nhận cảnh báo khi có vấn đề.
- Phát hành an toàn: Chạy evals và A/B test trước khi đổi model hoặc prompt để không làm giảm chất lượng trên production.
- Agent Development Lifecycle: Nắm các giai đoạn của một dự án agent, từ tìm hiểu nhu cầu đến bàn giao.
- Chọn use case: Ưu tiên bài toán theo giá trị, rủi ro và độ khả thi để dự án đầu tiên dễ thành công.
- Mức độ tự chủ: Quyết định agent được tự làm gì và phải hỏi gì, dựa trên mức rủi ro của từng hành động.
- Governance & trách nhiệm: Ghi log và bảo vệ dữ liệu để kiểm tra lại được ai đã làm gì, đáp ứng yêu cầu của doanh nghiệp.
- Tích hợp hệ thống hiện có: Kết nối với hệ thống lõi qua MCP gateway mà vẫn giữ đúng phân quyền của từng người dùng.
- Bàn giao & đo hiệu quả: Đặt tiêu chí thành công rõ ràng và hướng dẫn để người dùng thật sự sử dụng agent.
- Đề bài: Xây trợ lý cho một quy trình doanh nghiệp, ví dụ hỗ trợ khách hàng hoặc xử lý hồ sơ.
- Thiết kế kiến trúc: Vẽ kiến trúc và giải thích lý do cho từng lựa chọn, giống như khi làm dự án thật.
- Dựng bộ eval trước: Xác định tiêu chí thành công từ đầu để biết agent đã đạt yêu cầu hay chưa.
- Xây agent: Kết hợp Agentic RAG, tool qua MCP, memory và bước duyệt của con người vào một sản phẩm.
- Bảo mật & deploy: Thêm guardrail, tracing và triển khai lên cloud để sản phẩm chạy được với người dùng thật.
- Báo cáo kết quả: Trình bày số liệu về chất lượng, chi phí, độ trễ và viết README để đưa vào portfolio.
Đối tượng học
- Lập trình viên muốn chuyển sang làm AI Engineer.
- Backend hoặc Frontend Developer muốn đưa tính năng AI vào sản phẩm đang làm.
- Lập trình viên đã dùng thử LLM API, nhưng chưa biết cách làm RAG và agent chạy ổn định trong thực tế.
- Lập trình viên muốn xây dựng hệ thống agent cho doanh nghiệp một cách bài bản.
- Sinh viên CNTT đã biết lập trình và muốn có dự án AI hoàn chỉnh để đưa vào portfolio.
- Yêu cầu bạn đã có kiến thức nền tảng về lập trình Python. Nếu chưa nắm vững JavaScript, bạn nên học trước Python tại đây.
Học 1 Kèm 1 - Đảm bảo chất lượng Tốt Nhất
- Bạn sẽ được theo sát và hỗ trợ 1-1 bởi giảng viên. Đảm bảo chất lượng học tập đạt kết quả tốt nhất.
- Nếu HỌC CHẬM bạn không cần lo lắng không theo kịp chương trình, giảng viên sẽ đi chậm để đảm bảo bạn nắm chắc 100% kiến thức.
- Nếu học nhanh, bạn có thể nhanh chóng kết thúc chương trình để đi làm công ty.
Học online - Tiết kiệm thời gian di chuyển
Thay vì phải di chuyển vất vả trên đường giữa dòng người đông đúc. Giờ đây, bạn chỉ cần mở laptop để bắt đầu học ngay tại nhà. Tiết kiệm thời gian, tránh căng thẳng, và tập trung hoàn toàn vào việc học!
Lịch học linh hoạt
- LetDiv sắp xếp lịch học theo ý của bạn. Học đúng thời điểm mà bạn cảm thấy thoải mái nhất.
- Dễ dàng thay đổi lịch học trong khi học nếu bạn có việc bận. Không làm gián đoạn tiến độ học tập của bạn.
- LetDiv có thể sắp xếp thời gian học cho bạn từ 8h đến 23h, kể cả cuối tuần.
Áp dụng Scaffolding Learning
- Học dễ dàng từ cơ bản đến nâng cao qua từng bước nhỏ.
- Cá nhân hóa lộ trình học tập, nắm chắc kiến thức ngay lập tức.
- Tiến bộ vượt bậc nhờ phương pháp sư phạm khoa học hiệu quả.
Trải nghiệm thử buổi học
Bạn có thể tham khảo ngay một buổi học 1 Kèm 1 qua video sau, để hiểu rõ hơn phong cách giảng dạy và quy trình đào tạo của LetDiv sẽ diễn ra như thế nào:
Chính sách Hỗ trợ việc làm
- Hỗ trợ chỉnh sửa CV giúp hồ sơ của bạn nổi bật hơn, gia tăng cơ hội nhận lời mời phỏng vấn.
- Hỗ trợ giới thiệu hồ sơ đến các công ty lập trình Việt Nam.
- Có cơ hội thực tập tại LetDiv, tham gia vào phát triển dự án eLearning.
Chính sách hoàn tiền 100%
- Cam kết hoàn tiền 100% nếu bạn không hài lòng với chất lượng đào tạo trong 2 buổi đầu tiên.
- Quá trình hoàn tiền sẽ diễn ra nhanh chóng ngay trong ngày.
Học viên LetDiv đang làm ở đâu?
Đánh giá của học viên
Mình đã biết gọi API từ trước nhưng chưa hiểu vì sao hệ thống RAG của mình hay trả lời sai. Sau khóa học, mình biết cách dựng bộ eval và đo từng thay đổi bằng số liệu, nên không còn phải sửa theo cảm tính. Giảng viên theo sát, giải thích kỹ từng lỗi trong code của mình.
Giảng viên giải thích dễ hiểu và sửa bài rất kỹ. Mỗi lần code của mình có vấn đề, giảng viên đều chỉ rõ lỗi nằm ở đâu và vì sao nên làm theo cách khác, nên mình nhớ lâu hơn nhiều so với tự học.
Phần tự viết agent bằng API thuần giúp mình hiểu rõ agent hoạt động ra sao. Đến khi học LangGraph, mình biết framework đang làm hộ những gì và khi nào mới cần dùng.
Lịch học linh hoạt nên mình vừa đi làm vừa theo học được. Những tuần bận dự án, mình chỉ cần báo đổi lịch mà không bị đứt mạch kiến thức, nhờ vậy vẫn theo được đến dự án cuối khóa.
Mình là Backend Developer và cần đưa tính năng AI vào sản phẩm của công ty. Những bài về bảo mật, chi phí và triển khai thực tế giúp ích trực tiếp cho công việc. Dự án cuối khóa cũng giúp mình nhìn được toàn bộ quy trình, từ thiết kế kiến trúc đến deploy lên cloud.
Học 1 kèm 1 nên chỗ nào chưa hiểu mình hỏi được ngay, không phải ngại hay chờ đến cuối buổi. Những phần khó như context engineering và multi-agent, giảng viên đi chậm lại và cho ví dụ đến khi mình làm được mới chuyển sang phần tiếp theo.
Trước đây mình dùng coding agent theo kiểu giao việc rồi chấp nhận kết quả, nên code càng về sau càng khó kiểm soát. Sau bài về coding agent, mình biết chia việc theo từng giai đoạn, đặt quy tắc cho project và thêm test để agent tự phát hiện lỗi. Tốc độ vẫn nhanh mà mình yên tâm hơn hẳn khi đưa code lên.
Mình chọn khóa này vì muốn hiểu cách làm AI cho doanh nghiệp chứ không chỉ làm demo. Các bài về chi phí, monitoring và phân quyền đúng là những thứ mình cần, và dự án cuối khóa giúp mình có một sản phẩm hoàn chỉnh để đưa vào portfolio.
Hoàn tiền 100% nếu không hài lòng 2 buổi đầu tiên
Khóa học này bao gồm
- Thời lượng 23 buổi (3-4 tháng)
- 2-3 buổi/tuần (2.5 tiếng/buổi)
- 150 bài tập thực hành
- Hỗ trợ riêng 1-1
Hoàn tiền 100% nếu không hài lòng 2 buổi đầu tiên