

Nhờ có AI, giờ đây bạn có thể tạo ra một API chỉ trong vài phút, nhưng để API đó có thể:
- Xử lý hàng triệu request cùng lúc
- Đáp ứng được nhiều loại thiết bị khác nhau
- Đồng thời dễ dàng nâng cấp và chỉnh sửa trong thời gian dài
…thì đó lại là một câu chuyện hoàn toàn khác.
Một người kỹ sư phần mềm giỏi không chỉ đơn thuần tạo ra API, mà còn phải biết phân tích vấn đề và đưa ra được giải pháp thiết kế phù hợp cho từng tình huống cụ thể.
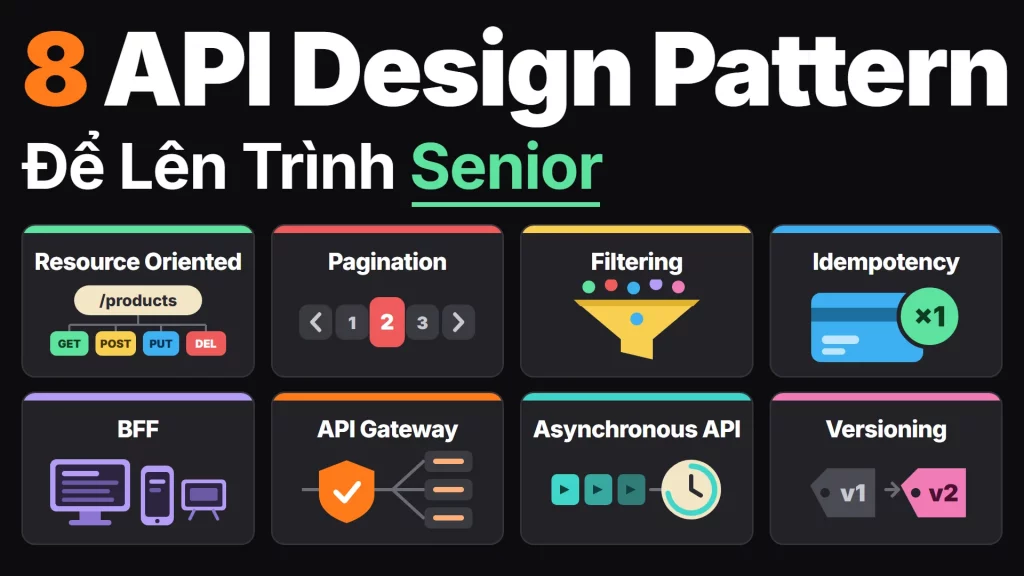
Vì vậy, trong bài viết này, mình sẽ chia sẻ cho bạn 8 API Design Pattern cần phải biết để có thể nâng cấp kỹ năng của mình lên trình độ senior.
Với mỗi pattern, mình sẽ đưa ra những vấn đề thực tế thường gặp trước, sau đó mới hướng dẫn bạn cách áp dụng pattern đó để giải quyết vấn đề nhé.
Resource-Oriented Design
Pattern thứ nhất là Resource-Oriented Design, hay còn gọi là thiết kế hướng tài nguyên.
Giả sử, bạn đang xây dựng API cho một hệ thống thương mại điện tử.
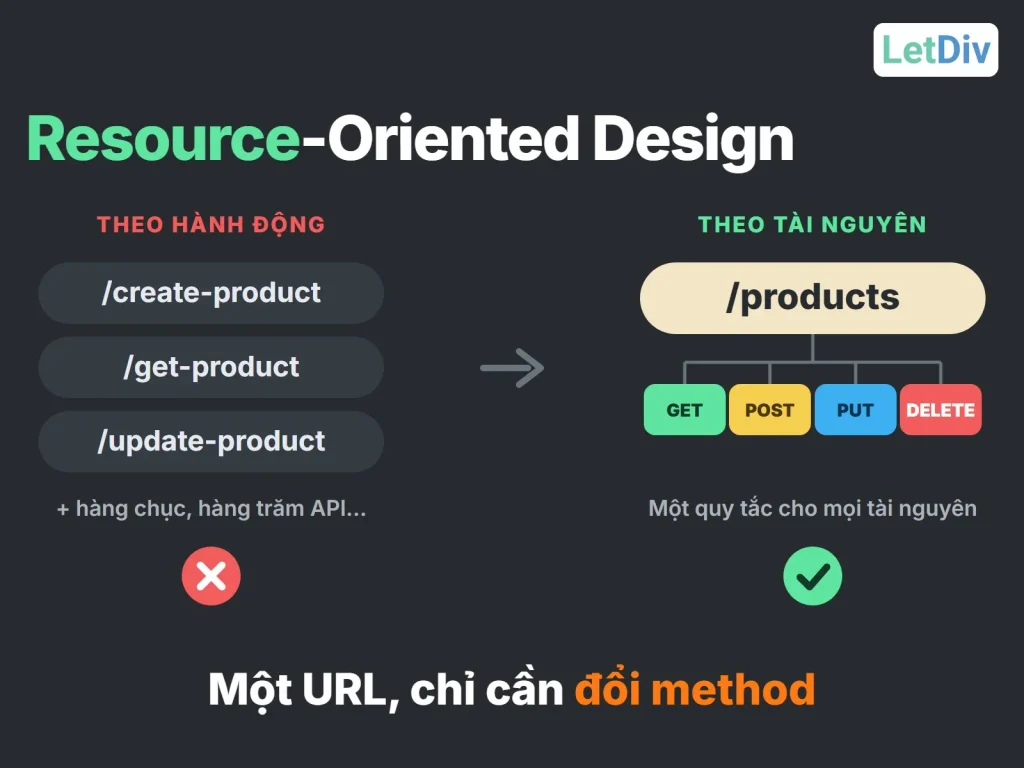
Lúc này, bạn sẽ có xu hướng đặt tên API theo “hành động”, nghĩa là cần làm gì thì tạo ra một API cho việc đó. Ví dụ:
- Muốn tạo sản phẩm thì đặt tên là
/create-product - Lấy thông tin sản phẩm thì đặt tên là
/get-product - Còn cập nhật sản phẩm thì đặt tên là
/update-product
Như vậy, chỉ riêng sản phẩm thôi đã có ít nhất 3 API, trong khi đó hệ thống của bạn còn có thêm nhiều tài nguyên khác như users, orders, payments,… và nếu tất cả đều được đặt tên tương tự như vậy, thì số lượng API sẽ nhanh chóng phình to lên hàng chục, thậm chí hàng trăm, khiến việc bảo trì về sau trở nên khó khăn hơn rất nhiều.
Không chỉ vậy, mỗi người trong team lại đặt tên theo một kiểu riêng:
- Người thì viết
/get-users - Người thì viết
/fetch-order-list
chẳng theo một quy tắc chung nào cả, khiến cho API vừa lộn xộn vừa khó bảo trì.
Mỗi lần muốn sử dụng thì đều phải tốn thời gian tra cứu tài liệu, hoặc thậm chí tệ hơn là phải đọc lại cả mã nguồn.
Để giải quyết vấn đề này, bạn nên thiết kế API theo chuẩn RESTful, tức là xoay quanh những “tài nguyên” có trong hệ thống như users, products hay orders, chứ không phải đặt tên theo “hành động”.
Lúc này, quy tắc chung rất đơn giản, đó là:
- URL sẽ cho biết bạn đang làm việc với “tài nguyên gì”
- Còn HTTP method sẽ cho biết bạn muốn “làm gì” với tài nguyên đó
Ví dụ:
- Để lấy danh sách sản phẩm, URL sẽ là danh từ số nhiều
/products, còn HTTP method sẽ làGET. - Còn khi muốn tạo sản phẩm mới, bạn vẫn dùng URL
/productsnhư cũ và chỉ cần đổi method thànhPOST. - Khi muốn cập nhật một sản phẩm cụ thể, ví dụ như sản phẩm có ID là 42, thì bạn thêm ID vào sau URL và dùng method
PUT. - Tương tự, muốn xóa sản phẩm đó thì bạn vẫn dùng URL có kèm ID như lúc cập nhật, chỉ cần đổi method thành
DELETElà xong.
Vì tất cả đều đi theo chung một quy tắc, nên bạn có thể dễ dàng đoán được API của những tài nguyên khác như orders hay users mà không cần tốn thời gian tra cứu tài liệu nữa.
Nhờ vậy mà hệ thống của bạn sẽ trở nên gọn gàng, thống nhất và dễ bảo trì hơn rất nhiều.
Pagination
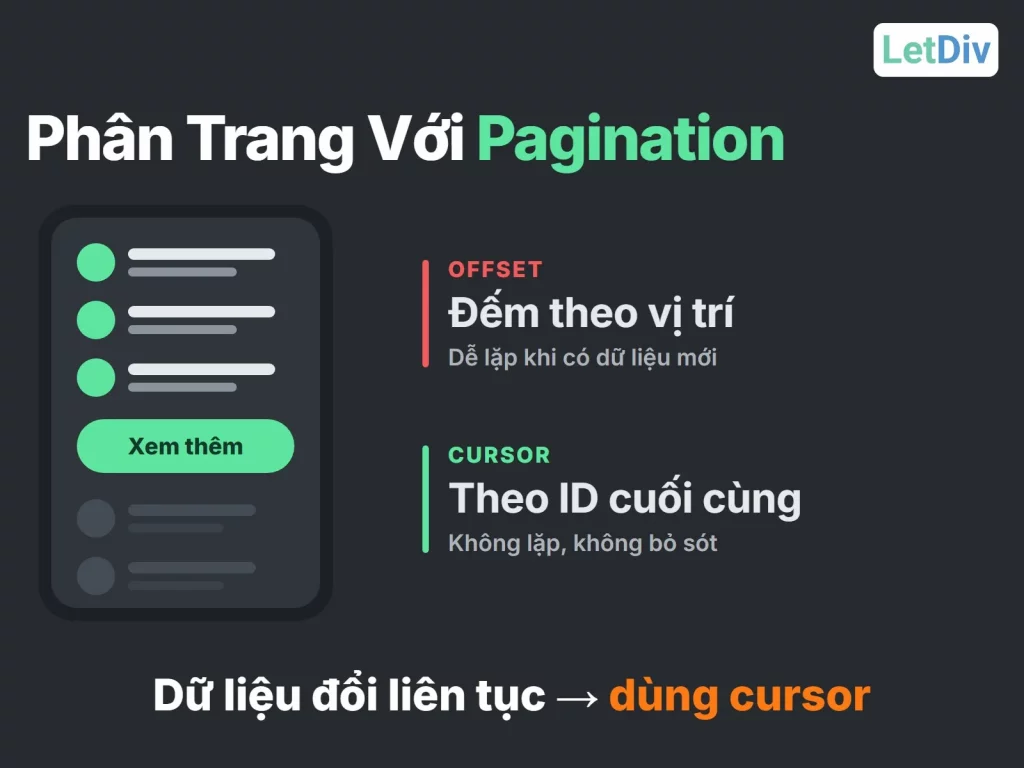
Pattern thứ hai là Pagination, hay còn gọi là phân trang.
Hãy tưởng tượng, bạn đang làm phần hiển thị danh sách bình luận cho một bài viết.
- Nếu bài viết đó chỉ có khoảng 10 bình luận, thì bạn có thể trả về toàn bộ danh sách trong một lần gọi API mà không gặp vấn đề gì cả.
- Nhưng nếu số bình luận của bài viết đó bỗng nhiên tăng lên hàng nghìn, thậm chí hàng chục nghìn, mà bạn vẫn trả về toàn bộ trong một lần gọi API, thì dữ liệu trả về sẽ trở nên rất nặng, khiến máy chủ tốn nhiều thời gian xử lý hơn.
Trong khi đó, người dùng lại phải chờ rất lâu để trang tải xong, dù thực tế họ thường chỉ đọc vài chục bình luận đầu tiên mà thôi.
Vì vậy, thay vì trả về toàn bộ, API sẽ trả về dữ liệu theo từng đợt, ví dụ:
- Khi mới mở bài viết thì ứng dụng chỉ tải 20 bình luận đầu tiên
- Và khi người dùng bấm vào nút “Xem thêm” thì mới tải 20 bình luận kế tiếp
Cách làm phổ biến nhất là ứng dụng sẽ gửi kèm hai thông số, bao gồm:
- Vị trí bắt đầu, hay còn gọi là
offset - Và số lượng bình luận cần lấy, hay còn gọi là
limit
Ví dụ:
- Khi mới mở bài viết, ứng dụng sẽ gửi giá trị
offsetbằng 0 vàlimitbằng 20, nghĩa là yêu cầu API lấy từ bình luận thứ nhất đến bình luận thứ 20. - Sau đó, khi người dùng bấm nút “Xem thêm”, ứng dụng sẽ gửi giá trị
offsetbằng 20 vàlimitbằng 20, nghĩa là yêu cầu API bỏ qua 20 bình luận đã xem trước đó và lấy tiếp từ bình luận thứ 21 đến thứ 40.
Cách làm này được gọi là offset-based pagination.
Tuy nhiên, với những dữ liệu thay đổi liên tục như bình luận, cách này lại có một nhược điểm.
Giả sử, bạn vừa đọc xong 20 bình luận đầu tiên thì có thêm một bình luận mới được đăng lên đầu danh sách.
Lúc này toàn bộ bình luận cũ sẽ bị đẩy lùi xuống một vị trí, nên khi bạn bấm “Xem thêm”, thì bình luận thứ 20 mà bạn vừa đọc sẽ xuất hiện lại thêm một lần nữa.
Để giải quyết vấn đề này, thay vì gửi offset để đếm theo vị trí, ứng dụng sẽ gửi ID của bình luận cuối cùng mà bạn vừa xem, và yêu cầu API lấy tiếp 20 bình luận nằm ngay sau bình luận đó.
Cách làm này được gọi là cursor-based pagination.
Nhờ vậy, dù bài viết liên tục có thêm bình luận mới, thì mỗi lần bạn bấm nút “Xem thêm”, API vẫn trả về đúng những bình luận tiếp theo mà không bị lặp lại hay bỏ sót.
Tóm lại:
- Offset-based pagination phù hợp khi dữ liệu ít thay đổi và cần nhảy đến trang bất kỳ
- Còn cursor-based pagination phù hợp với dữ liệu lớn và thay đổi liên tục
Filtering & Field Selection
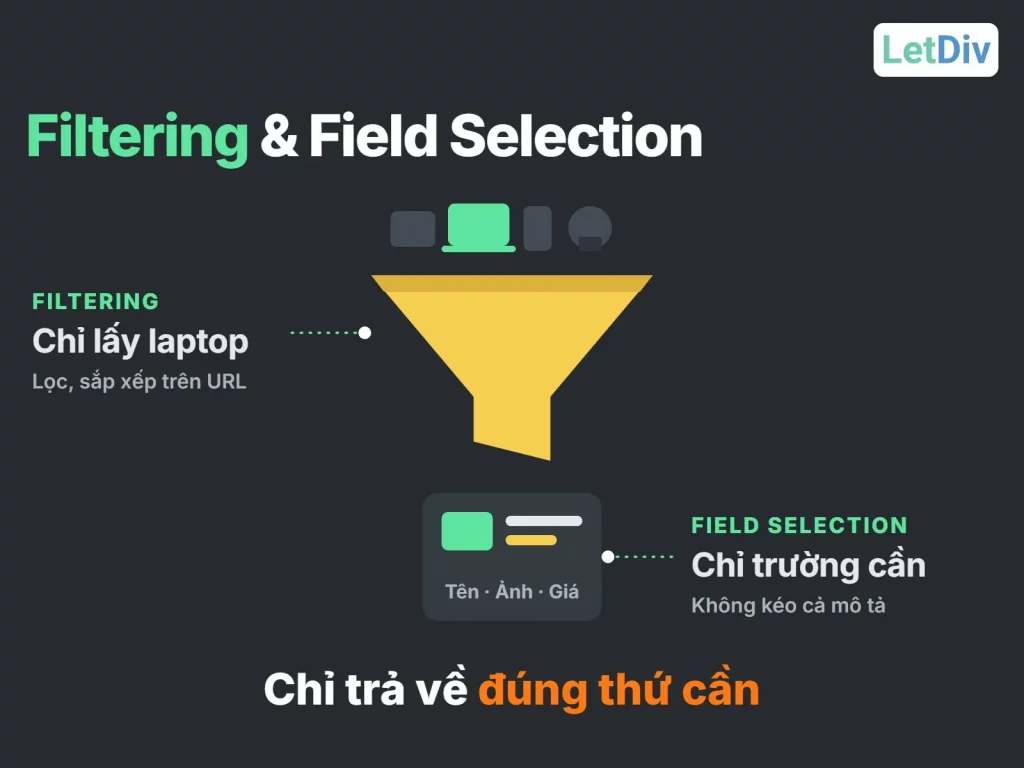
Pattern thứ ba là Filtering và Field Selection, hay còn gọi là lọc dữ liệu và chọn trường dữ liệu.
Nếu kỹ thuật pagination giúp API kiểm soát được số lượng dữ liệu cần trả về trong mỗi lần gọi, thì Filtering và Field Selection sẽ giúp API chỉ trả về đúng những dữ liệu mà ứng dụng thực sự cần.
Giả sử, bạn đang vào một trang web bán hàng và muốn lọc ra các sản phẩm là laptop, rồi xếp giá từ thấp đến cao.
Lúc này, nếu API không hỗ trợ lọc dữ liệu, thì hệ thống sẽ phải trả về toàn bộ danh sách sản phẩm, bao gồm cả:
- Điện thoại
- Tai nghe
- Bàn phím,…
Khi đó, ứng dụng phải tự lọc sản phẩm nào là laptop rồi sắp xếp lại. Việc này khiến ứng dụng chạy chậm đi, và gây ra trải nghiệm xấu cho người dùng.
Để giải quyết vấn đề này, bạn nên thiết kế API cho phép truyền điều kiện lọc và sắp xếp ngay trên URL.
Bên cạnh đó, API cũng nên cho phép ứng dụng chọn ra những thông tin cần thiết, hay còn gọi là Field Selection.
Ví dụ, mỗi sản phẩm có thể chứa rất nhiều thông tin như tên, ảnh, giá, mô tả chi tiết, thông số kỹ thuật,…, nhưng ở trang danh sách, ứng dụng chỉ cần hiển thị tên, ảnh và giá mà thôi.
Khi đó, ứng dụng chỉ cần gửi kèm những trường cần dùng ngay trên URL, và API sẽ chỉ trả về đúng những thông tin đó.
Nhờ vậy, dữ liệu trả về sẽ nhẹ hơn, và ứng dụng cũng hoạt động nhanh hơn.
Idempotency
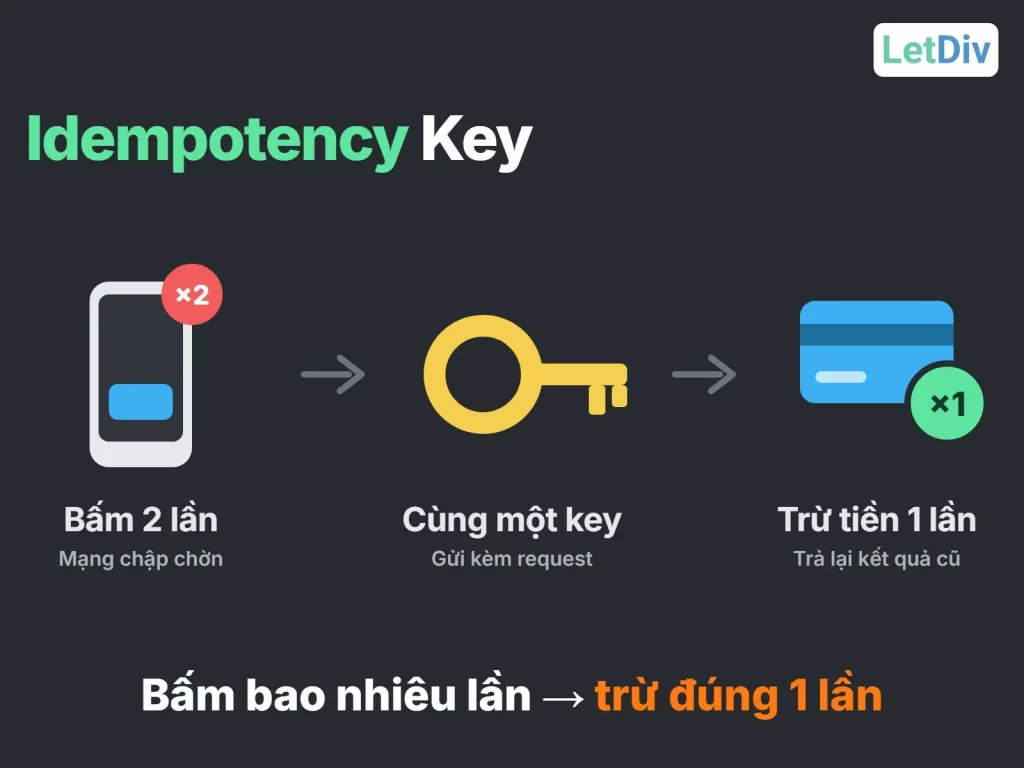
Pattern thứ tư là Idempotency, và đây là pattern giúp bạn tránh được lỗi bị trừ tiền hai lần liên tiếp khi thanh toán.
Giả sử, bạn mua hàng xong, và bấm nút thanh toán, lúc này request đã được gửi đến máy chủ và tiền trong tài khoản của bạn cũng đã bị trừ đi.
Thế nhưng, đúng lúc này mạng lại bị chập chờn, khiến cho nội dung thông báo không thể gửi được về ứng dụng.
Do chờ quá lâu mà không thấy phản hồi, bạn thường có xu hướng bấm thanh toán thêm một lần nữa, và thế là máy chủ trừ tiền của bạn thêm lần thứ hai.
Để giải quyết vấn đề này, bạn nên thiết kế API sao cho dù bấm thanh toán bao nhiêu lần đi chăng nữa, thì tài khoản cũng chỉ bị trừ tiền đúng một lần thôi.
Giải pháp phổ biến nhất là dùng idempotency key, nghĩa là:
- Khi bắt đầu thanh toán một đơn hàng, ứng dụng sẽ tạo ra một mã duy nhất rồi gửi kèm theo request
- Còn máy chủ sẽ lưu mã này lại cùng với kết quả xử lý
Lúc này, nếu bạn lỡ bấm thanh toán thêm một lần nữa, ứng dụng vẫn gửi kèm mã cũ, nên máy chủ nhận ra ngay đây là yêu cầu đã xử lý rồi, và chỉ trả về kết quả trước đó thay vì tiếp tục trừ tiền của bạn.
Nếu bạn đang mất gốc hoặc cảm thấy bế tắc khi vibe coding tại vì không thực sự hiểu và kiểm soát được những gì do AI tạo ra, thì hãy tham khảo ngay các khóa học lập trình 1 Kèm 1 của LetDiv nhé!
Backend for Frontend (BFF)
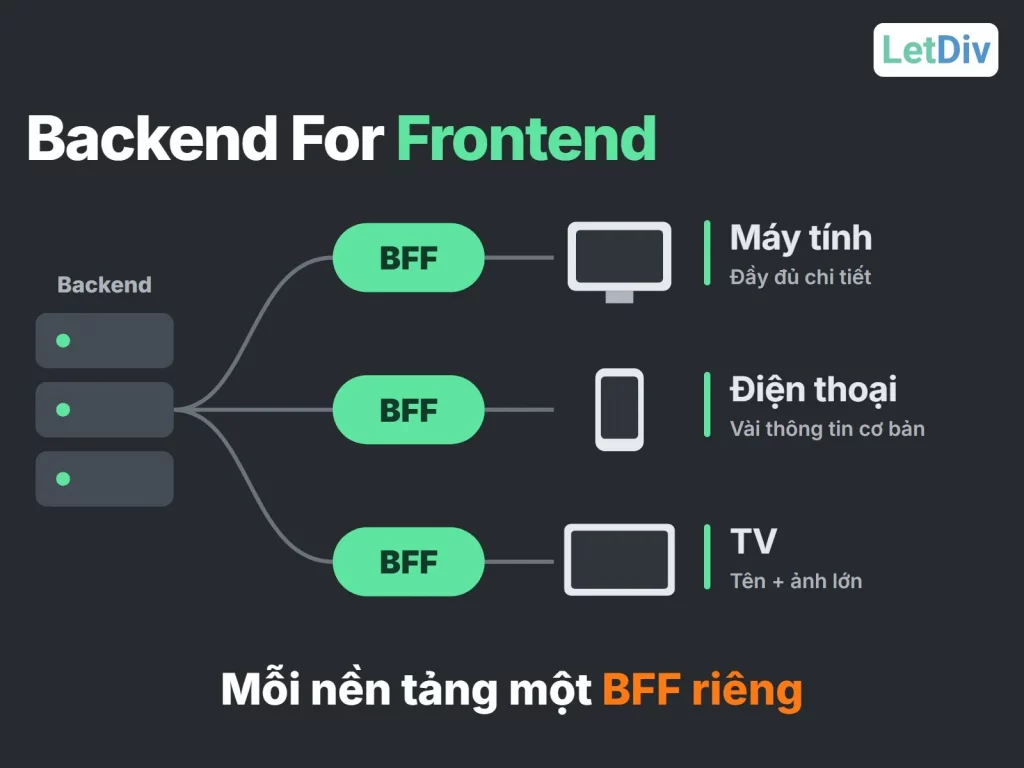
Pattern thứ năm là Backend for Frontend.
Giả sử, bạn đang phát triển một ứng dụng chạy trên cả 3 nền tảng là máy tính, điện thoại và TV, và tất cả chúng đều lấy dữ liệu từ cùng một backend.
Tuy nhiên, mỗi nền tảng lại cần những dữ liệu hoàn toàn khác nhau.
Ví dụ, tại màn hình trang chủ:
- Máy tính sẽ hiển thị đầy đủ thông tin chi tiết, hình ảnh và đánh giá của sản phẩm.
- Trong khi đó, điện thoại có màn hình nhỏ hơn, nên chỉ hiển thị vài thông tin cơ bản.
- Còn đối với TV thì người dùng thường ngồi xa, nên chủ yếu hiển thị tên và hình ảnh kích thước lớn.
Lúc này, nếu cả ba đều dùng chung một API, thì bạn chỉ có hai lựa chọn:
- Một là trả về toàn bộ dữ liệu để nền tảng nào cũng có thể sử dụng. Nhưng việc này lại khiến điện thoại chạy chậm, vì phải tải về rất nhiều dữ liệu không cần thiết.
- Hai là thêm hàng loạt điều kiện riêng cho từng nền tảng vào backend. Tuy nhiên, mã nguồn sẽ trở nên ngày càng phức tạp và khó bảo trì.
Để giải quyết vấn đề này, bạn nên tạo cho mỗi nền tảng một lớp API trung gian nằm giữa ứng dụng và máy chủ, và đây chính là Backend for Frontend, hay còn gọi tắt là BFF.
Bạn có thể hiểu đơn giản, lớp này không xử lý logic nghiệp vụ, mà chỉ có nhiệm vụ lấy dữ liệu từ máy chủ rồi sắp xếp lại để phù hợp với từng nền tảng cụ thể. Ví dụ:
- BFF của máy tính sẽ trả về đầy đủ thông tin chi tiết, hình ảnh và đánh giá của sản phẩm.
- Trong khi đó, BFF của điện thoại chỉ trả về vừa đủ những thông tin cơ bản như tên, giá và hình ảnh thu nhỏ của sản phẩm.
- Còn BFF của TV thì chỉ trả về tên và hình ảnh kích thước lớn.
Đến đây, có lẽ bạn sẽ thắc mắc, tại sao chúng ta không dùng luôn Field Selection, mà phải tạo thêm các lớp BFF cho phức tạp.
Thực ra:
- Field Selection chỉ giúp ứng dụng bỏ bớt những trường dư thừa trong một API
- Còn BFF có thể gom dữ liệu từ nhiều API khác nhau rồi sắp xếp lại, nên ứng dụng chỉ cần gọi đúng một lần là có đủ thông tin cần hiển thị
Nhờ vậy, mỗi nền tảng đều nhận được đúng dữ liệu cần thiết, còn mã nguồn trên backend cũng trở nên gọn gàng và dễ bảo trì.
API Gateway
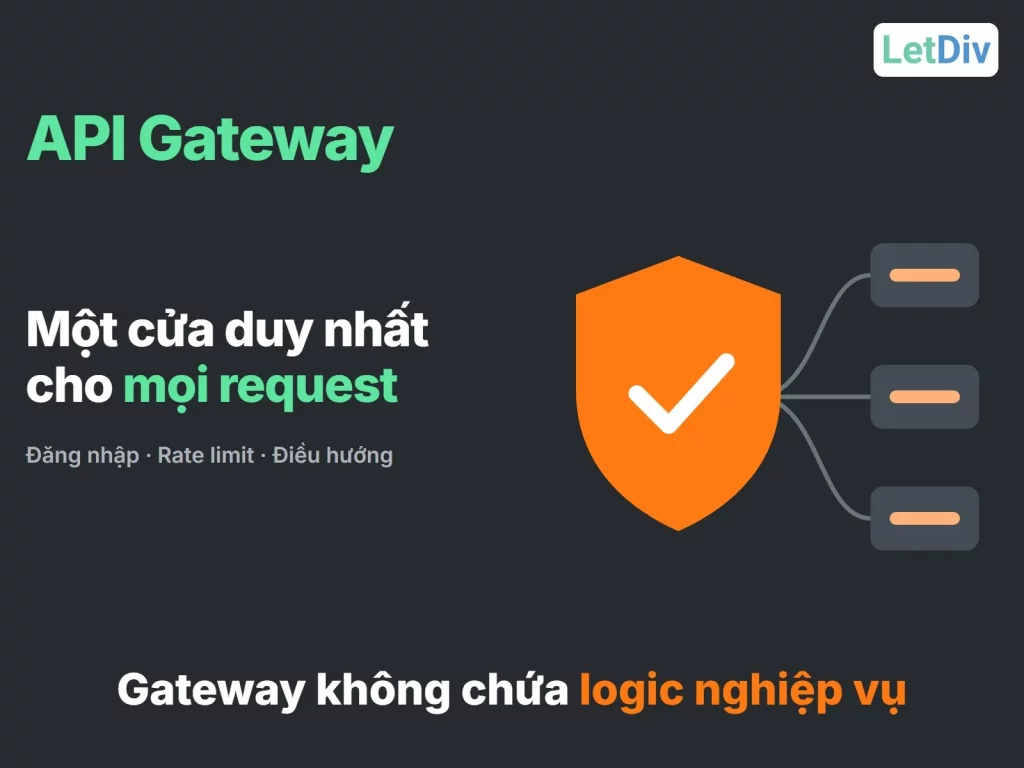
Pattern thứ sáu là API Gateway.
Giả sử, bạn đang làm việc với một hệ thống microservices, nghĩa là thay vì gom hết vào một chỗ, hệ thống sẽ được chia nhỏ thành nhiều service khác nhau, ví dụ như:
- Service người dùng
- Service sản phẩm
- Hay service đơn hàng
Và mỗi service sẽ có một địa chỉ IP riêng.
Vấn đề ở đây là:
- Ứng dụng phải tự nhớ địa chỉ IP của từng service, chỉ cần một service đổi địa chỉ thôi thì ứng dụng bắt buộc phải cập nhật theo.
- Rắc rối hơn, mỗi service đều phải tự viết phần kiểm tra đăng nhập, nên mỗi khi muốn chỉnh sửa cơ chế đăng nhập, thì bạn phải sửa lại toàn bộ các service.
Để giải quyết vấn đề này, bạn nên tạo một API Gateway ở phía trước tất cả các service.
Chức năng của nó là tiếp nhận toàn bộ request được gửi đến từ ứng dụng.
API Gateway sẽ thực hiện ba nhiệm vụ sau:
- Thứ nhất, kiểm tra xem người dùng là ai và đã đăng nhập hay chưa.
- Thứ hai, giới hạn số lượng request mà mỗi người dùng được gửi trong một khoảng thời gian, hay còn gọi là rate limit.
- Cuối cùng, chuyển request đến đúng service cần xử lý.
Tuy nhiên, có một điều bạn cần lưu ý là không nên đưa logic nghiệp vụ vào API Gateway, ví dụ như thanh toán hay kiểm tra tồn kho, vì những việc này phải do các service đảm nhận.
Nhờ vậy:
- Ứng dụng chỉ cần nhớ đúng một địa chỉ của API Gateway, nên dù service nào có thay đổi địa chỉ IP thì ứng dụng cũng không bị ảnh hưởng theo.
- Đồng thời, phần kiểm tra đăng nhập cũng chỉ cần viết một lần duy nhất tại API Gateway. Khi muốn chỉnh sửa cơ chế đăng nhập, bạn chỉ cần sửa đúng một chỗ thôi.
Asynchronous API
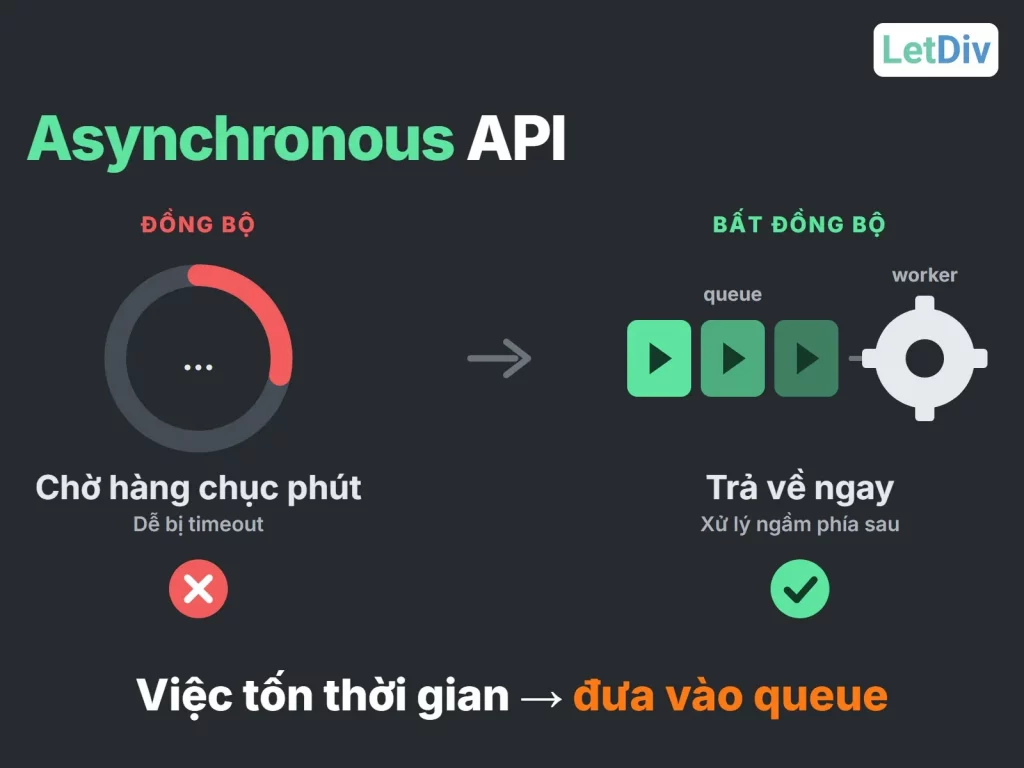
Pattern thứ bảy là Asynchronous API, hay còn gọi là API bất đồng bộ.
Giả sử, bạn đang làm chức năng upload video, và sau khi tải lên, bạn cần chuyển đổi video sang nhiều độ phân giải khác nhau để người dùng có thể chọn được chất lượng phù hợp với tốc độ mạng của mình.
Nếu API xử lý theo kiểu đồng bộ, nghĩa là phải chuyển đổi xong hết tất cả các độ phân giải rồi mới trả kết quả về, thì sau khi bấm upload xong, bạn sẽ phải ngồi chờ vài phút, thậm chí là vài chục phút.
Trong khoảng thời gian đó, bạn chỉ biết ngồi nhìn icon loading xoay tròn trên màn hình.
Còn nếu chờ quá lâu, kết nối có thể bị ngắt giữa chừng, hay còn gọi là timeout, khiến bạn tưởng ứng dụng bị lỗi rồi upload lại từ đầu.
Để giải quyết vấn đề này:
- Sau khi vừa upload video xong, API sẽ trả về ngay thông báo đã upload thành công, để bạn không phải ngồi chờ quá trình chuyển đổi độ phân giải nữa.
- Sau đó, công việc này sẽ được đưa vào một hàng đợi, hay còn gọi là queue. Rồi có một chương trình chạy ngầm bên dưới, hay còn gọi là worker, lần lượt lấy ra từng video để chuyển đổi.
- Sau khi hoàn thành, máy chủ sẽ gửi thông báo ngược lại về ứng dụng, và lúc này video đã có thể xem được ở mọi độ phân giải khác nhau.
Nhờ vậy, ứng dụng sẽ không còn bị treo khi làm việc với những tác vụ mất nhiều thời gian. Trong khi đó, bạn vẫn có thể thoải mái làm tiếp những công việc khác.
Versioning
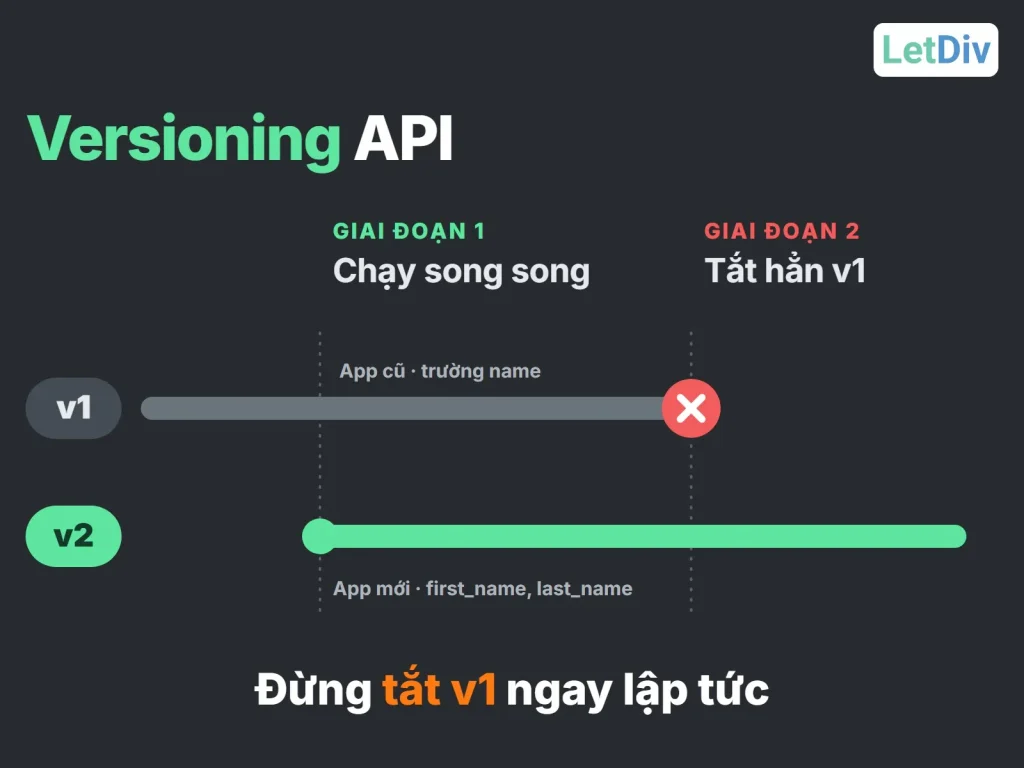
Pattern thứ tám là Versioning, hay còn gọi là quản lý phiên bản API.
Trong quá trình phát triển, sớm muộn gì bạn cũng sẽ phải chỉnh sửa lại API của mình.
Giả sử, bạn đang có một ứng dụng di động với hơn hàng nghìn người dùng, và API lấy thông tin tài khoản đang trả về đầy đủ họ tên trong một trường name duy nhất.
Sáu tháng sau, bạn muốn tách trường name thành hai trường là first_name và last_name để dễ quản lý hơn.
Khi đó, bạn cũng sẽ phải phát hành phiên bản mới cho ứng dụng, với hai ô nhập liệu riêng cho họ và tên.
Thế nhưng, không phải ai cũng cập nhật ứng dụng lên phiên bản mới ngay, vẫn còn rất nhiều người đang sử dụng phiên bản cũ.
Phiên bản cũ này vẫn đang gọi API và lấy họ tên từ trường name, nếu bạn xóa trường này đi, thì ứng dụng cũ có thể bị lỗi ngay lập tức.
Vậy làm thế nào để API vừa hỗ trợ được phiên bản cũ, và vừa hỗ trợ được phiên bản mới?
Cách đơn giản nhất là bạn vẫn giữ nguyên trường name và chỉ thêm first_name và last_name vào dữ liệu API trả về, khi đó ứng dụng cũ vẫn có thể lấy trường name như bình thường.
Tuy nhiên, có những thời điểm thay đổi lớn đến mức buộc bạn phải bỏ luôn cấu trúc API cũ.
Dù vậy, bạn cũng không nên bỏ ngay lập tức, mà cần có kế hoạch chuyển đổi dần dần qua hai giai đoạn:
- Giai đoạn thứ nhất, bạn chạy song song hai phiên bản API, trong đó:
- Ứng dụng cũ vẫn tiếp tục gọi đến version 1 (
/v1/users) và nhận về trườngname - Còn ứng dụng mới thì gọi đến version 2 (
/v2/users) và nhận về 2 trườngfirst_namevàlast_name
- Ứng dụng cũ vẫn tiếp tục gọi đến version 1 (
- Giai đoạn thứ hai, khi hầu hết người dùng đã cập nhật lên ứng dụng mới, bạn thông báo trước một khoảng thời gian rồi mới tắt hẳn version 1 đi.
Nhờ vậy, bạn vẫn có thể tiếp tục phát triển API mà không lo làm ảnh hưởng đến những người đang sử dụng ứng dụng cũ.
Bạn cũng cần lưu ý rằng, không phải cứ có thay đổi là chúng ta lại tạo ra một phiên bản mới cho API.
Tại vì mỗi phiên bản đều phải được bảo trì riêng, nên càng nhiều phiên bản thì việc quản lý chúng sẽ ngày càng trở nên phức tạp.
Tổng kết
Tóm lại, 8 pattern này không phải là những mẹo để bạn học thuộc lòng, mà là cách giúp bạn nhìn ra vấn đề trước, rồi mới chọn ra được giải pháp phù hợp cho API của mình.
Nếu bạn đang mất gốc và muốn khôi phục lại kiến thức để có thể đi làm, hãy tham khảo ngay các khóa học lập trình 1 Kèm 1 của LetDiv nhé!